Международная олимпиада по информатике (IOI) и Международная математическая олимпиада (IMO) представляют собой два уникальных соревнования, каждое из которых требует от участников различных навыков. IOI сосредоточена на алгоритмах и программировании, где участники должны писать код, который проходит скрытые тесты в условиях строгих временных и лимитированных подач. В то время как IMO требует от участников строгих доказательств на естественном языке. Успех на обеих олимпиадах — это не просто достижение, а показатель более широких возможностей.
Недавние результаты показывают, что Nemotron является мощной и адаптируемой основой для создания специализированных моделей мирового уровня. Начиная с Nemotron 3, наши команды использовали методы контролируемой дообучения (SFT), обучения с подкреплением (RL) и обратной связи для создания систем, которые достигли уровня золотой медали как на IMO 2026, так и на IOI 2026.
Результаты соревнований
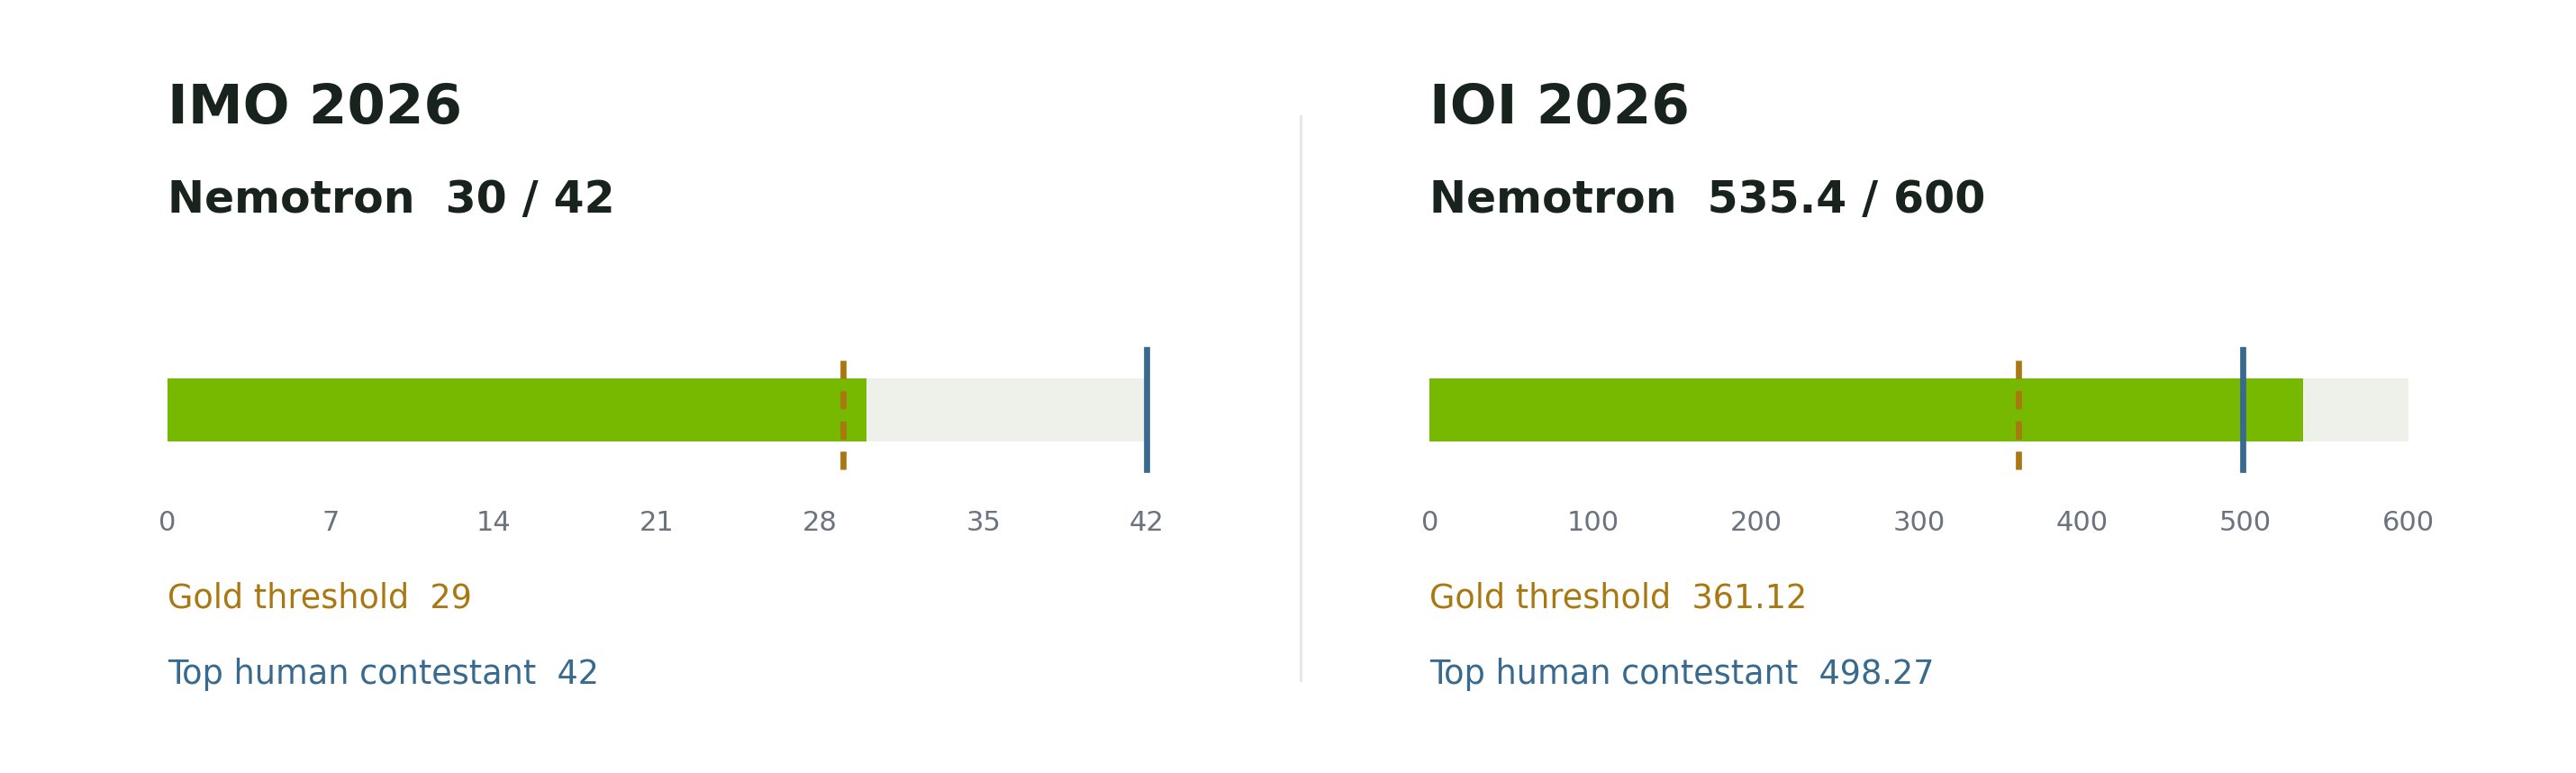
| Соревнование | Модель | Результат | Порог золотой медали | Лучший человеческий результат |
|--------------|--------|-----------|---------------------|-------------------------------|
| IOI 2026 | Nemotron-3-Ultra-CC с SFT и GenCorrect | 535.4/600 | 361.12 | 498.27 |
| IMO 2026 | Nemotron 3 Ultra, SFT и RL | 30/42 | 29 | - |
Результат IOI был получен в ходе живого, перспективного запуска при тех же условиях времени, доступа в интернет и подачи, что и у человеческих участников. Это был неофициальный, несупервизированный тест, который не был включен в официальное ранжирование IOI. Доказательства системы IMO были оценены официальными оценщиками IMO.
Рецепт специализации
Процесс создания специализированной модели можно разбить на четыре ключевых этапа:
1. Начать с сильной базовой модели Nemotron.
2. Кураторство задач, специфичных для области, и высококачественных логических следов.
3. Применение стандартных методов пост-тренировки, таких как SFT и, где это полезно, RL.
4. Сочетание специализированной модели с циклом вывода, который генерирует, оценивает и улучшает кандидатные ответы.
Обучение и выводы были значительными, но основной подход оказался знакомым и воспроизводимым. Не потребовалось создавать новую базовую модель для каждой задачи; мы адаптировали Nemotron для конкретной задачи.
От общей кодировки до золота IOI
Для соревнований по программированию мы отобрали 22,000 задач и сгенерировали синтетические логические следы для обучения двух специалистов. Nemotron-3-Nano-CC с 30 миллиардами параметров и 3 миллиардами активных параметров прошел как SFT, так и RL. Nemotron-3-Ultra-CC с 550 миллиардами параметров и 55 миллиардами активных параметров прошел SFT.
Прогресс на IOI 2025 продемонстрировал ценность специализации. Nano улучшился с 130 до 280 баллов после пост-тренировки, а затем до 291 после RL. С использованием GenCorrect, нашей итеративной стратегии генерации-оценки-улучшения, он достиг 468 баллов, превысив золотой порог в 438.3. Ultra-CC достиг 502 баллов с той же стратегией.
Обучение Nemotron доказывать, проверять и пересматривать
Проект IMO применил ту же идею к математике олимпиад. Начиная с Nemotron 3 Ultra, мы обучили одного специалиста с SFT и другого с RL. Корпус SFT содержал 414,890 качественно отфильтрованных примеров по 15,818 уникальным задачам на доказательство. Данные охватывали генерацию доказательств, их уточнение, проверку и мета-проверку, так что модель научилась строить аргументы, выявлять пробелы, реагировать на критику и оценивать полноту доказательства.
Модель RL была обучена на 9,597 задачах на доказательство, выбранных близко к границе возможностей модели. Оба пост-тренировочных контрольных пункта превзошли общедоступную модель в экспериментальных разработках. Контрольный пункт SFT был самым сильным на первом этапе поиска, в то время как контрольный пункт RL достиг лучшего общего результата.
Синергия дообучения и вычислений в момент тестирования
Ранее мы показали, как вычисления в момент тестирования могут повысить производительность моделей до уровня золотой медали. Новые результаты добавляют важный элемент: лучшая специализация дает системе вывода лучших кандидатов, лучших критиков и лучшие уточнения. На IOI GenCorrect превратил приросты от дообучения в более значительные улучшения за несколько раундов обратной связи. На IMO использование взаимодополняющих контрольных пунктов SFT и RL оказалось более ценным, чем просто выбор большего количества образцов из одной контрольной точки.
Открытые модели и данные на Hugging Face
Мы хотим, чтобы эти результаты были полезны не только для соревнований. Коллекция Nemotron Labs IMO 2026 объединяет контрольные точки SFT и RL, оба набора данных для обучения и Nemotron-IMO-Bench, новый бенчмарк из 200 задач олимпиадного уровня. Статья по IMO описывает подход к обучению и систему генерации-проверки-улучшения, в то время как репозиторий NeMo-Skills включает в себя инференс-пайплайн IMO, подсказки, поданные доказательства и воспроизводимый быстрый старт. Для соревнований по программированию модель Nemotron-3-Ultra-CC доступна на Hugging Face, а статья по IOI предоставляет рецепт обучения и методологию GenCorrect.
Вместе IMO и IOI предоставляют необычно строгие доказательства простой идеи: Nemotron может быть дообучен в специализированные модели мирового уровня, а затем объединен с прозрачными рабочими процессами вывода для решения задач на грани человеческой конкуренции. Мы с нетерпением ждем, что сообщество Hugging Face создаст дальше.
Комментарии (0)