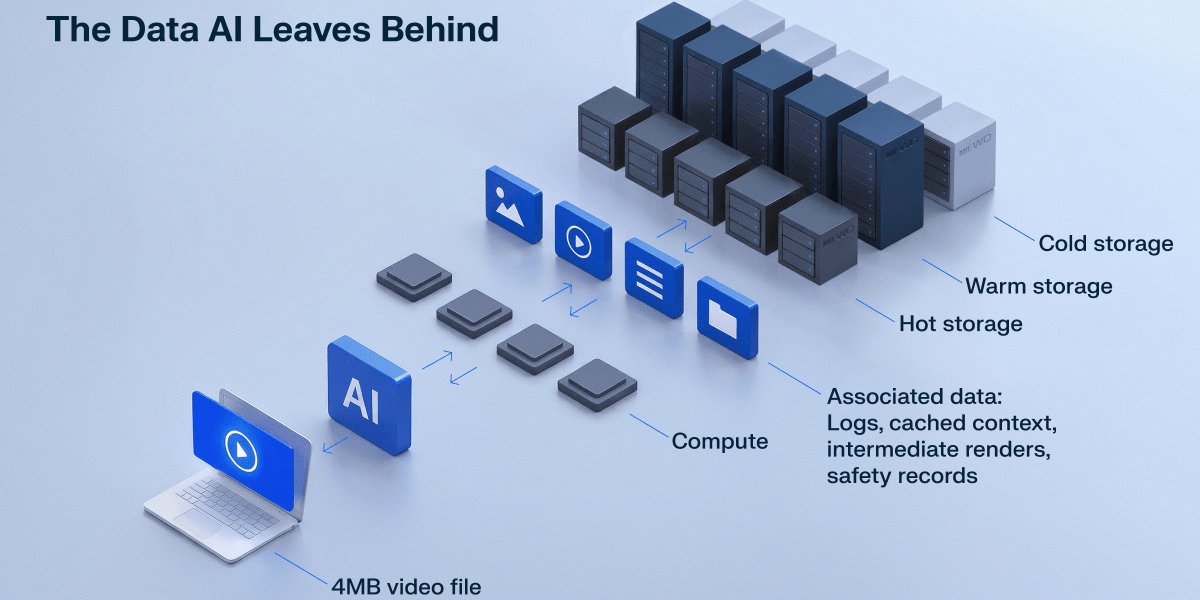
Когда речь заходит о затратах на искусственный интеллект, большинство руководителей представляют себе графические процессоры (GPU) — ряды ускорителей, потребляющих гигаWatты энергии, и очереди на получение кремниевых чипов. Однако в этом представлении часто упускается важный аспект: затраты на хранение данных. Что происходит с данными после того, как модель дает ответ? Большая часть бэкэнд-данных, генерируемых миллиардами ежедневных запросов, изображений и видео, требует хранения. Но затраты на хранение данных — это одна из самых сложных инфраструктурных статей расходов для планирования, и она часто игнорируется на начальных этапах проектирования инфраструктуры ИИ.
Рост объема данных при масштабировании инференса
Традиционно обсуждения инфраструктуры ИИ сосредоточены на вычислительно интенсивном процессе обучения модели. Обучение имеет конечный характер: запуск начинается, потребляет вычислительные ресурсы и заканчивается. В отличие от этого, инференс происходит непрерывно, каждый раз, когда модель отвечает на запрос. Эта разница имеет значение для планирования инфраструктуры: запуск обучения — это проект, который можно запланировать и завершить. Инференс же не прекращается; каждый запрос на инференс оставляет после себя след.
Например, в случае с видео, сгенерированным ИИ, затраты на бэкэнд могут оказаться значительными. Согласно внутренним измерениям компании WD, 8-секундный клип (возвращаемый пользователю в виде файла 720p размером 3.97 МБ) оставляет более 500 МБ связанных данных на бэкэнде, включая логи, кэшированный контекст, немедленные рендеры, резервные копии и записи безопасности. Это увеличение в 130 раз по сравнению с размером выходного файла, который увидел пользователь. Масштабируя это на предприятие, генерирующее более длинные и высококачественные видео, бэкэнд-объем данных может вырасти до сотен гигабайт на клип.
Прогнозы роста спроса на инференс
Согласно прогнозам McKinsey, спрос на инференс ИИ будет расти на 35% в год до 2030 года, в то время как для обучения этот показатель составит 22%, что к концу десятилетия составит более 40% от общего спроса на центры обработки данных. Недавний глобальный отчет IDC, спонсируемый WD, показал, что почти 95% респондентов сообщили о росте объема данных из-за генеративного ИИ за последние 12 месяцев, при этом примерно 61% отметили рост на 25% и более.
Оптимизация хранения для повышения производительности
"Можно рассматривать увеличение объема хранения как оптимизацию для поддержания занятости GPU", — отметил старший менеджер по продуктам одного из поставщиков облачных услуг в отчете. "Самая большая проблема заключается в том, чтобы убедиться, что GPU не простаивают, ожидая появления данных — часы простоя GPU становятся очень дорогими очень быстро". В денежном эквиваленте: если ваши затраты на хранение растут на 25% в год, в то время как бюджет на вычисления растет более предсказуемым циклическим образом, затраты на хранение начинают опережать бюджетную строку, которая получает наибольшее внимание.
Жизненный цикл данных и его влияние на бюджет
Спрос на вычисления возрастает и падает в зависимости от циклов обучения, запусков продуктов и обновлений оборудования. Однако объем хранимых данных не уменьшается, когда спрос на вычисления замедляется. Логи моделей, синтетические выходные данные, результаты инференса и многое другое продолжают накапливаться, и организации хранят больше данных на более длительный срок. Это меняет роль хранимых данных. Информация, которая раньше перемещалась в архив и редко всплывала, теперь может стать входными данными для будущих рабочих нагрузок ИИ.
С увеличением объема хранимых данных, которые необходимо извлекать и повторно использовать, хранилище должно поддерживать не только растущую емкость, но и динамический доступ к данным. Согласно тому же опросу WD-IDC, 96% респондентов ожидают, что им потребуется более быстрый доступ к архивам для поддержки инференса или генерации, дополненной извлечением (RAG).
Как правильно планировать бюджет на ИИ
Для финансового директора или CIO это означает, что "затраты на инфраструктуру ИИ" могут быть слишком узко определены только вычислениями. Модель, которая простаивает, пока загружаются данные, стоит столько же, сколько и та, что простаивает из-за нехватки GPU. Однако узкое место в хранении остается скрытым до тех пор, пока не станет проблемой, проявляясь в операционных расходах и задержках извлечения, а не в капитальных затратах рядом с ускорителями.
Рассмотрим, например, розничного продавца, который генерирует AI-видео продуктов для своего каталога, или страховую компанию, обрабатывающую документы по претензиям через RAG для более быстрого андеррайтинга. В обоих случаях затраты на вычисления — это известная, запланированная величина: ставка за генерацию или за запрос, которую финансы могут прогнозировать. Затраты на хранение отличаются: они накапливаются с каждым сгенерированным видео и каждой обработанной претензией, потому что ни один из этих бэкэнд-данных не исчезает после завершения задачи.
Стратегия хранения для масштабируемости
Решение этой проблемы начинается с архитектуры. Стратегия хранения, как правило, разрабатывается для производительности горячего уровня (для данных, которые доступны мгновенно и постоянно), в то время как большинство данных ИИ по объему накапливается в теплых, холодных и прохладных уровнях. Предприятиям необходимо экономически масштабируемое хранилище: инфраструктура, спроектированная для полного жизненного цикла данных ИИ, балансирующая производительность с емкостью, мощностью, надежностью и общей стоимостью владения по мере того, как данные сохраняются, накапливаются и все чаще повторно используются.
Это также означает, что необходимо рассматривать архивы, которые раньше оставались без дела, как активные активы для RAG и инференса, и устанавливать политики хранения с учетом растущей стратегической ценности данных, а не их первоначальных затрат на хранение. Кроме того, необходимо осознавать, что решения о хранении принимаются на уровне флота, а не отдельных дисков. Такая инфраструктура требует наличия уровней хранения, где индивидуальное потребление энергии, надежность, плотность и эксплуатационная эффективность определяют, останется ли система экономически жизнеспособной по мере масштабирования емкости.
Вопросы для анализа бюджета на инфраструктуру ИИ
Существует три вопроса, которые следует задать о бюджете на инфраструктуру ИИ вашей организации:
Какова наша политика хранения данных для контента, сгенерированного ИИ, и кто ее устанавливает?
Привязаны ли наши закупки хранилищ к потребностям в производительности во время обучения или к фактическому жизненному циклу данных, которые мы производим?
Если наше использование ИИ удвоится в следующем году, удвоятся ли наши затраты на хранение вместе с ним или даже больше?
Большинство организаций не могут уверенно ответить на все три вопроса. Это и есть та пропасть, которую стоит преодолеть до следующего бюджетного цикла, а не после.
Комментарии (0)