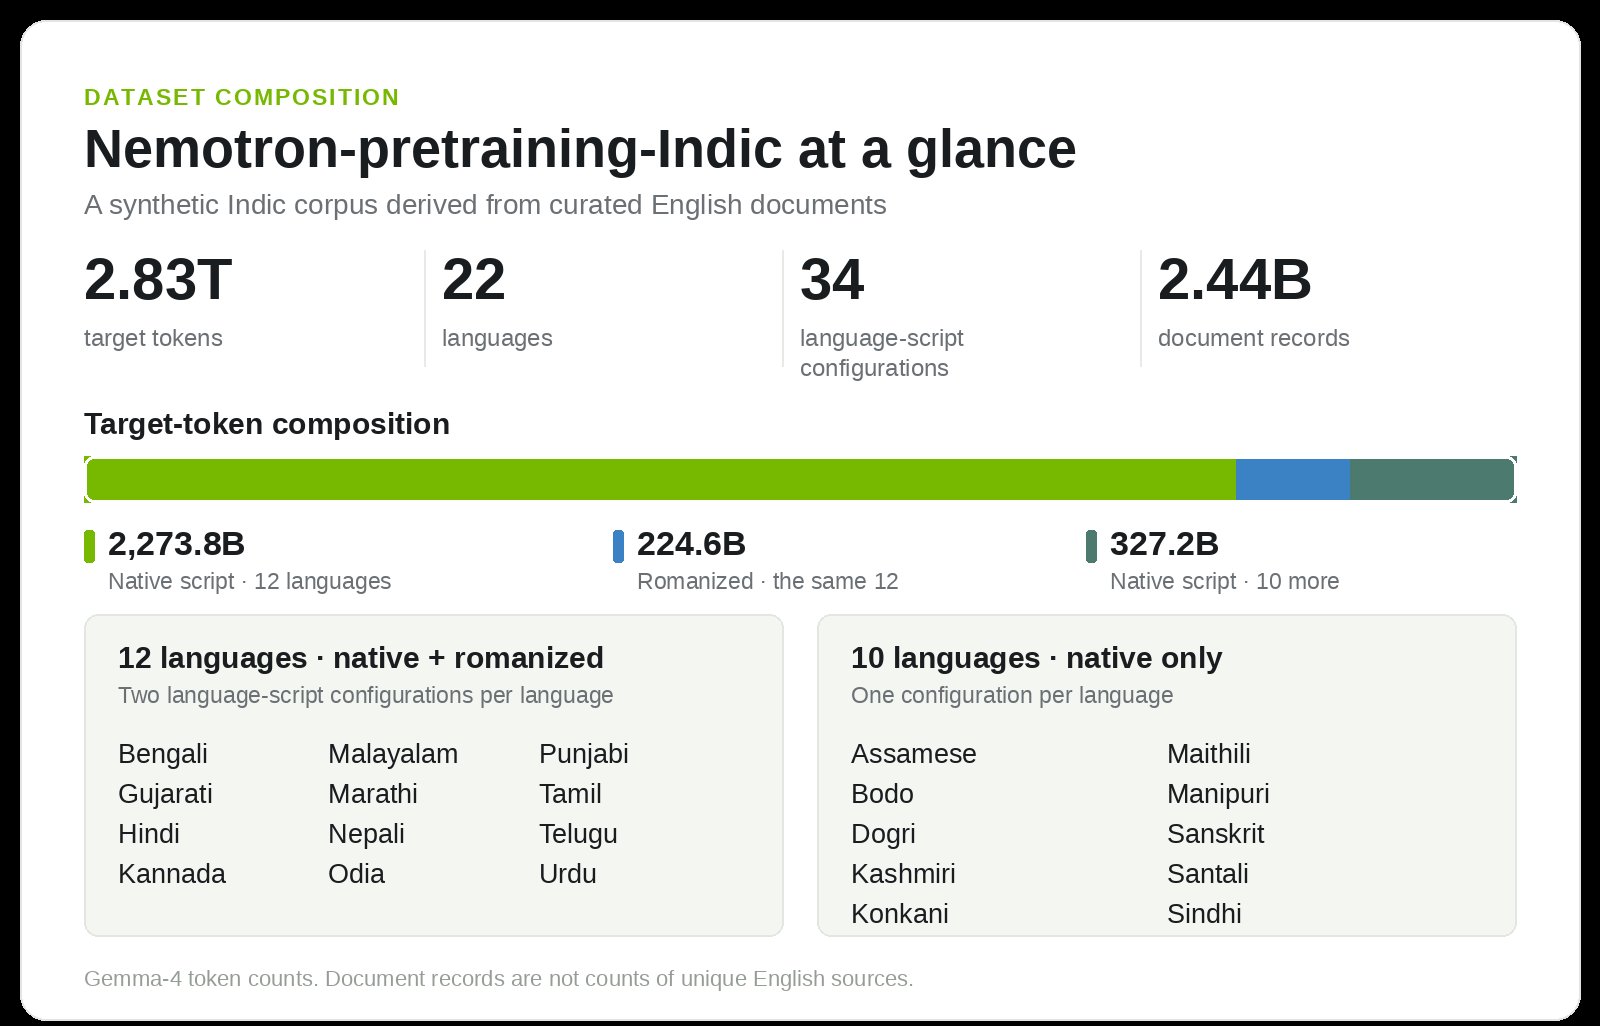
В мире искусственного интеллекта и обработки естественного языка индийские языки долгое время оставались в тени, уступая английскому языку в области доступных данных и технологий. Однако недавний проект, инициированный AI4Bharat и NVIDIA, обещает изменить эту ситуацию с помощью нового корпуса данных под названием Nemotron-pretraining-Indic-v1, который включает в себя около 2.8 триллионов токенов на 22 индийских языках.
Объем и состав корпуса
Корпус Nemotron охватывает 22 языка, указанные в Конституции Индии, что составляет первую языковую базу для 97% индийцев, или почти 1.2 миллиарда граждан по данным переписи 2011 года. Эти языки включают:
Бенгали
Гуджарати
Хинди
Каннада
Малаялам
Маратхи
Непали
Одиа
Панджаби
Тамильский
Телугу
Урду
Ассамский
Бодо
Догри
Кашмири
Конкани
Майтхили
Манипури
Санскрит
Сантали
Синди
Корпус содержит 2,601 триллиона токенов на родном письме и 224.6 миллиарда токенов в романизированном виде, что позволяет использовать его для обучения моделей, способных работать с различными сценариями и форматами.
Процесс генерации данных
Проект был разработан в сотрудничестве с IIT Madras, ведущим инженерным институтом Индии, и AI4Bharat, лабораторией, занимающейся исследованиями в области индийских языков. Генерация данных осуществляется с помощью открытой, ускоренной на GPU, системы, которая включает в себя:
Перевод документов
Оценку качества перевода
Целевое исправление ошибок
Каждый этап процесса обеспечивает сохранение контекста и точности, что особенно важно для технических текстов, включая математические уравнения и код. Все записи отслеживаются до исходного документа, что позволяет разработчикам легко проверять качество и достоверность данных.
Обеспечение качества и адаптация
Для обеспечения качества перевода используется модель Gemma-4-31B-it, которая позволяет оценивать каждую выходную запись по сравнению с английским источником. Применяется рубрика, основанная на Multidimensional Quality Metrics (MQM), которая классифицирует ошибки перевода по типу и серьезности. Только записи, получившие оценку не ниже 75 из 100, включаются в корпус, что обеспечивает высокий уровень качества данных.
Преимущества и возможности
Nemotron-pretraining-Indic-v1 не только предоставляет обширный набор данных для обучения моделей, но и открывает новые возможности для разработчиков. Открытый рецепт генерации данных позволяет командам адаптировать его под свои нужды, создавая новые наборы данных на основе собственных источников. Это значительно упрощает процесс создания моделей, способных объяснять технические концепции и отвечать на вопросы на индийских языках.
Будущее индийских языков в AI
Согласно Митешу Хапре, руководителю AI4Bharat, основная проблема заключается в недостатке данных для индийских языков. Проект Nemotron отвечает на этот вызов, предлагая не только обширный корпус данных, но и открытые инструменты для его генерации. Это позволит разработчикам создавать более сильные модели, способные работать с индийскими языками, и, в конечном итоге, улучшить технологии обработки естественного языка в Индии.
Заключение
Nemotron-pretraining-Indic-v1 представляет собой значительный шаг вперед в области технологий индийских языков, предоставляя разработчикам необходимые ресурсы для создания более качественных языковых моделей. Открытость данных и процессов генерации создаёт новые горизонты для исследований и разработок в этой области, что, безусловно, повлияет на будущее индийских языков в мире искусственного интеллекта.
Комментарии (0)