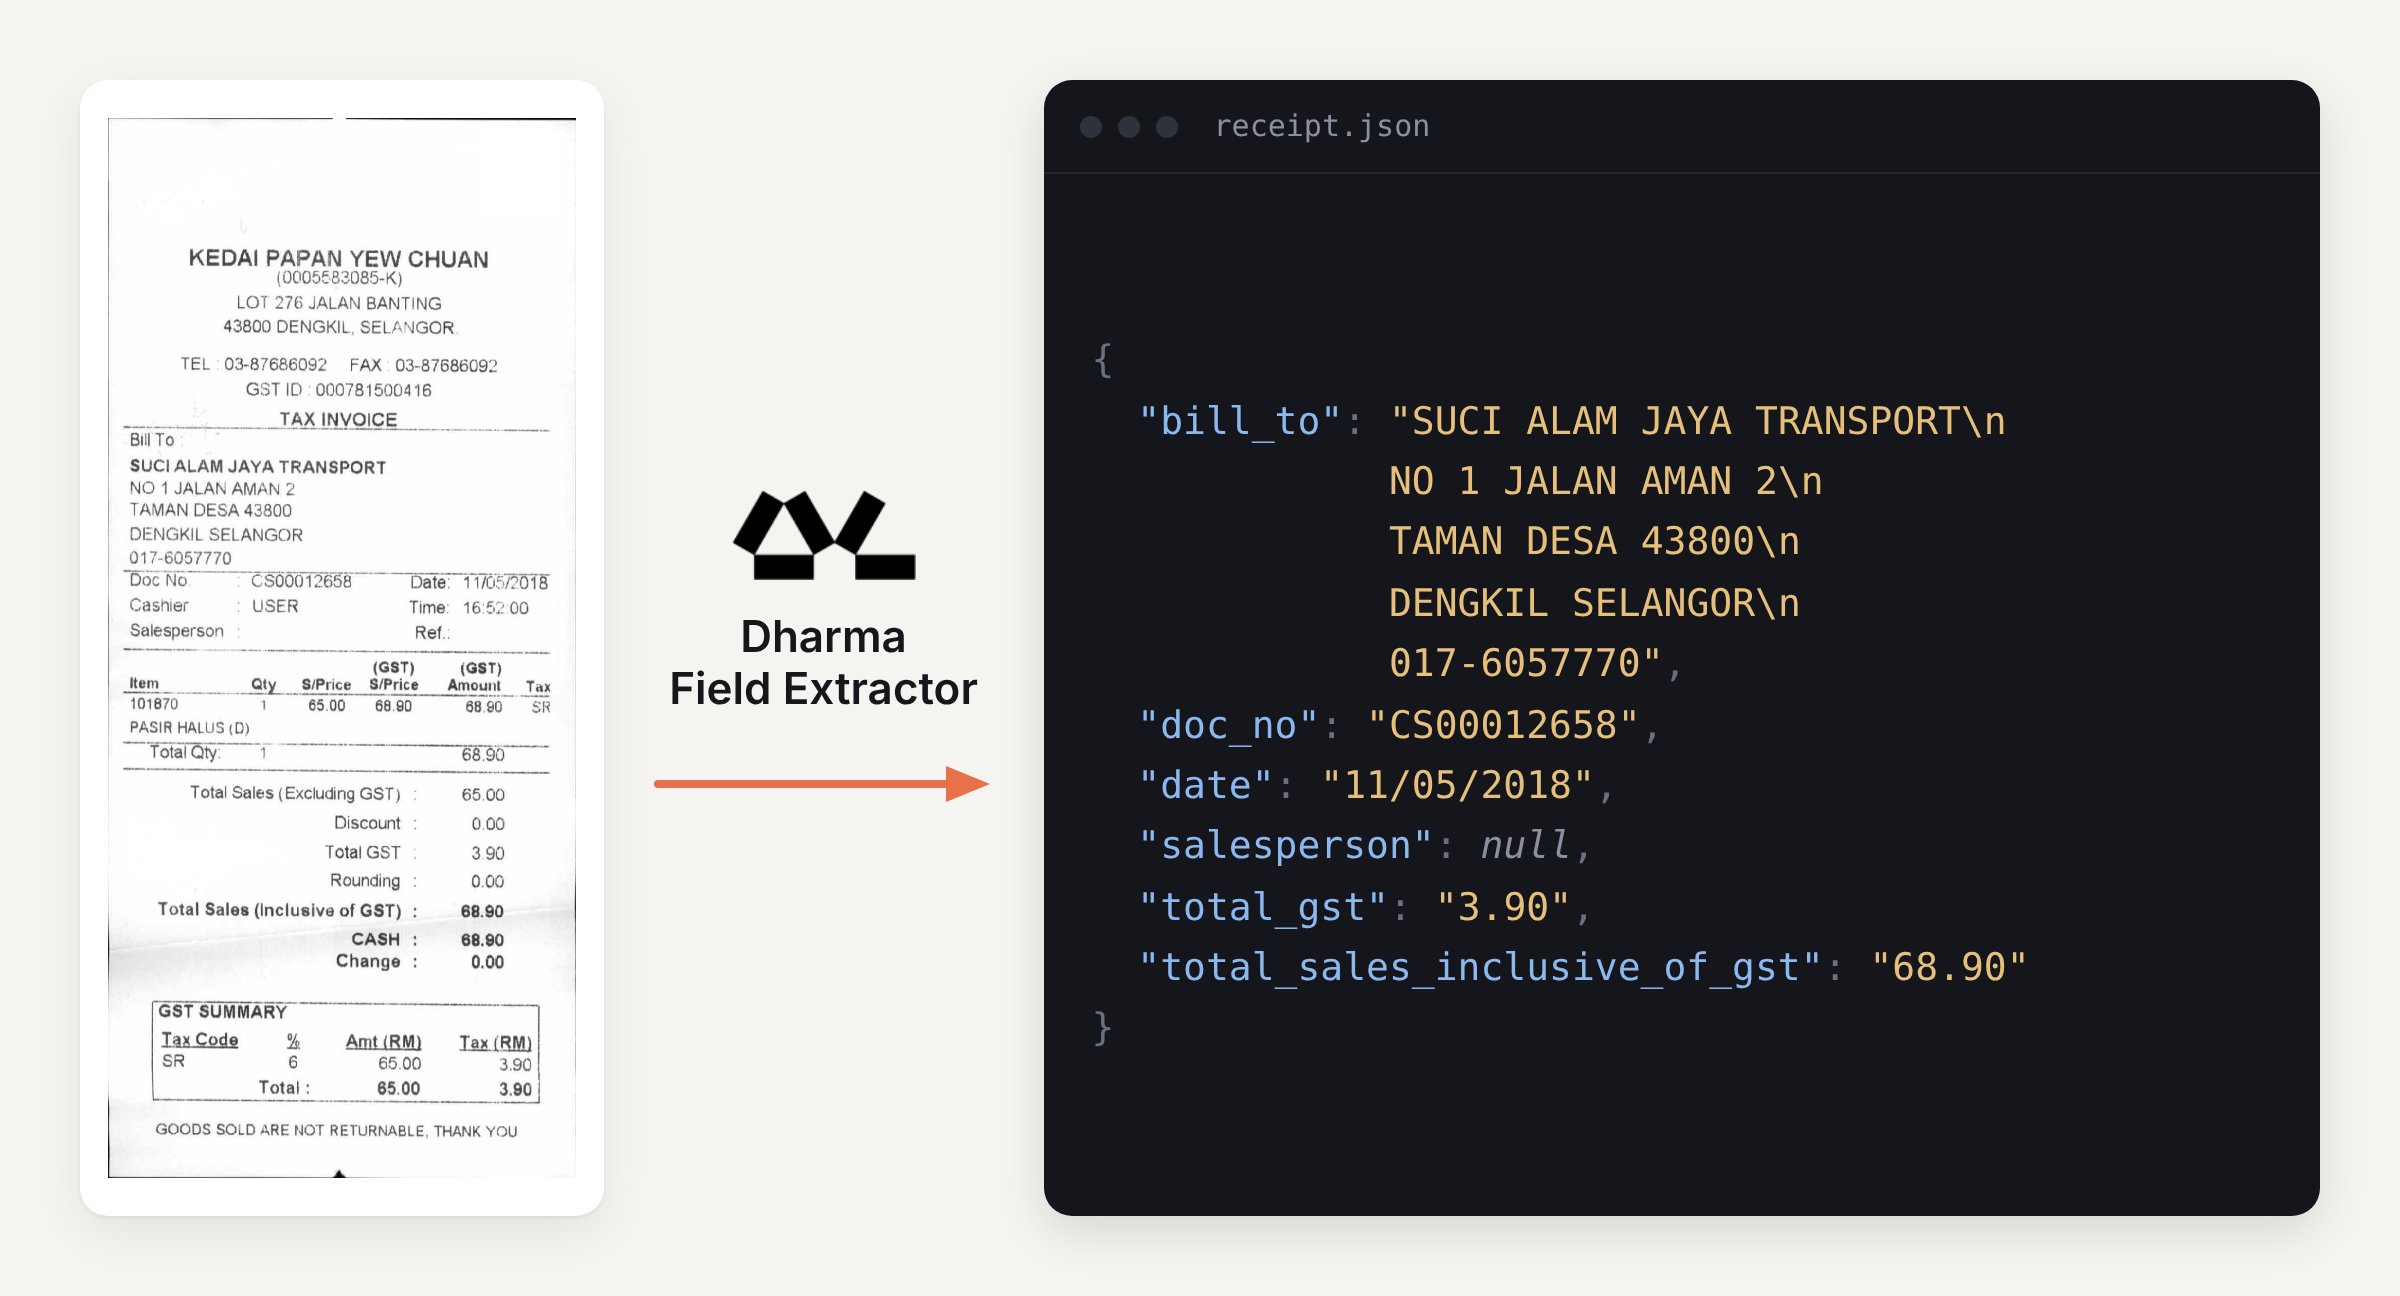
В апреле был представлен DharmaOCR-LITE — модель с 2 миллиардами параметров, специализирующаяся на оптическом распознавании текста (OCR) для различных типов документов, включая контракты, судебные документы, счета, удостоверения личности и формы. Исследование, лежащее в основе этой модели, подчеркивает важность специализации: меньшая модель, обученная на конкретной задаче, превосходит универсальные API на этой же задаче.
Преимущества OCR
OCR позволяет извлекать текст с документа, сохраняя оригинальное форматирование. Это особенно важно, когда необходимо работать с полными документами, такими как контракты или рукописи. Однако существует и другая задача: извлечение конкретных полей из документа в формате, который может быть использован в последующих системах. Например, необходимо получить все позиции из счета в виде списка, имя пациента и дату из медицинского запроса, или поля удостоверения личности, сопоставленные с колонками записи сотрудника. При использовании стандартного OCR вы получаете весь текст, но без указания, какие данные соответствуют каким полям. Для этого требуется дополнительная обработка кода, что может быть дорогостоящим и времязатратным процессом.
Field Extractor: решение для извлечения полей
DharmaOCR-LITE предлагает решение в виде Field Extractor, который принимает изображение документа и запрос на извлечение данных. Существует два способа запроса:
Открытый запрос: модель анализирует документ и определяет, какие части являются структурированными полями, возвращая все найденные данные в виде пар ключ-значение.
Запрос с заданной схемой: вы указываете точную структуру, которую хотите получить, с типами данных для каждого поля (строка, число или логическое значение). Модель вернет данные в формате JSON, соответствующем заданной схеме.
Как проходило обучение модели
Базовая модель DharmaOCR-LITE v1.1, состоящая из 2 миллиардов параметров, была оптимизирована и обучена на 43,384 примерах. Данные были организованы в три потока:
1.
Многоязычные данные: разнообразные документы, собранные из открытых источников.
2.
Данные бразильского домена: реальные документы на португальском языке.
3.
Многоязычные данные: документы на других европейских и азиатских языках для расширения обобщения.
Все три потока аннотированы на уровне полей, что позволяет модели эффективно работать с различными типами документов.
Оценка качества модели
Полная оценка модели охватывает 546 документов и 1,638 случаев извлечения данных. Оценка производится по метрике F1 на уровне полей, с учетом позиции внутри таблицы и схожести значений. Мы протестировали модель на четырех универсальных конфигурациях, и разрыв в качестве варьировался от 1.8 до 9.3 баллов. Стоимость использования DharmaOCR-LITE оказалась в 6-147 раз ниже, чем у конкурентов, что делает ее более экономически выгодным решением.
Примеры работы модели
В тестах на публичных наборах данных SROIE и FUNSD модель успешно извлекала все запрашиваемые поля, включая сложные случаи с многострочными адресами и чекбоксами. Например, на чеке SROIE модель вернула все 18 полей, включая те, что были пустыми, корректно обозначив их как null.
Заключение
DharmaOCR-LITE демонстрирует, что специализированные модели могут превосходить универсальные решения, особенно в рамках четко определенных задач. Это подтверждает основную идею Dharma-AI: для решения конкретной задачи не обязательно использовать самые большие модели, достаточно обучить модель, соответствующую вашим требованиям. Попробуйте DharmaOCR-LITE на своих документах на сайте dharma-ai.com.
Комментарии (0)