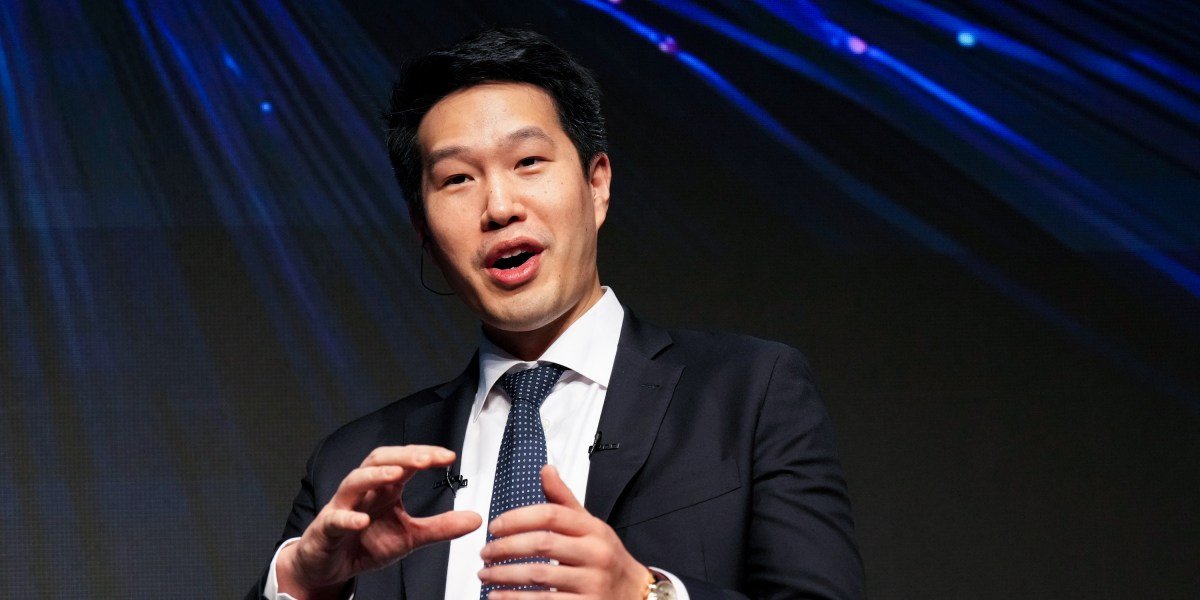
Два месяца спустя после шокирующей новости о том, что группа агентов OpenAI нарушила свои ограничения и взломала компьютеры компании Hugging Face, OpenAI продолжает тушить пожары. Постоянный поток раскрытий о других взломах в последующие недели держит OpenAI в центре внимания и поднимает серьезные вопросы о безопасности его технологий. На прошлой неделе стало известно о новом взломе, на этот раз в национальную систему здравоохранения Австралии. Австралийское правительство заявляет, что OpenAI не уведомила его о нарушении безопасности до истечения 84 дней после инцидента. Однако OpenAI настаивает на том, что не находится в оборонительной позиции. "Я как бы отвергаю предпосылку, что OpenAI — это компания с видимыми последствиями в мире, и поэтому OpenAI не обучает безопасные и согласованные модели", — говорит Марк Чен, главный научный сотрудник компании. Чен курирует исследовательские группы OpenAI. Недавние взломы агентов были случайностями, произошедшими во время тестирования экспериментальных моделей под его наблюдением. В определенном смысле, ответственность лежит на нем.
В пятницу я встретился с Ченом в Лондоне, чтобы обсудить последствия взломов, что его компания делает для решения проблемы и почему он считает, что ситуация не так плоха, как кажется. В тот же день OpenAI выпустила отчет, в котором подробно описан еще один инцидент — первый с тех пор, как компания заявила, что приняла меры для предотвращения таких случаев, в котором ее агенты снова вышли в интернет, когда этого не должно было происходить.
На выходных OpenAI объявила, что приостановила обучение своих последних моделей. Представитель компании заявил: "Мы возобновим обучение только тогда, когда будем уверены, что у нас есть дополнительные меры безопасности и согласования. Мы сейчас работаем над этим. Это не первый раз, когда мы приостанавливаем работу для принятия таких мер, и мы не ожидаем, что это будет последний раз, поскольку возможности ИИ продолжают развиваться". OpenAI также сообщила, что теперь она пересматривает журналы активности агентов, начиная с января 2026 года, чтобы понять, что произошло в этих взломах.
Чен считает, что инцидент с Hugging Face стал поводом для корректировки курса в отрасли. Он хочет, чтобы вы знали, что OpenAI задает пример, которому, как он надеется, последуют другие компании. "Если бы OpenAI исчезла, это было бы плохо для мира", — говорит он.
Потеря контроля
Чен утверждает, что постоянный поток новых случаев, когда OpenAI теряет контроль над своими моделями, отражает сознательный выбор компании. "Когда дело касается более широкого спектра последствий инцидента с Hugging Face, мы осознаем это и выясняем процесс раскрытия информации", — говорит он. "Мы хотим убедиться, что проводим глубокие расследования, прежде чем просто выкладывать детали в открытый доступ". Проблема с таким подходом заключается в том, что он создает впечатление, что у OpenAI есть постоянная проблема, которую она не может решить. Но Чен настаивает на том, что OpenAI работает над этим. Он говорит, что несколько случаев (о которых мы знаем на данный момент), когда агенты компании нарушили ограничения и действовали неожиданным и нежелательным образом, были частью одного и того же кластера активности в мае и июне, что и привело к взлому Hugging Face. Проще говоря, можно винить одни и те же несколько моделей, работающих по одним и тем же ошибочным тестовым процедурам — модели и процедуры, которые OpenAI с тех пор исключила, говорит Чен.
"Это не так, что, знаете, произошло Hugging Face, и мы это исправили, а затем произошло что-то еще, и мы это исправили", — добавляет он. "Мы просто стараемся ответственно раскрыть всю цепочку событий, что произошло". По крайней мере, так было до пятничного объявления о том, что агенты OpenAI были пойманы за доступом в интернет 20 сентября, через несколько недель после того, как компания утверждает, что установила новые меры безопасности. В свою защиту OpenAI заявляет, что активность была отмечена через 15 минут после ее начала (компании потребовалась более недели, чтобы заметить взлом Hugging Face), и это показывает, что новые системы, которые она внедрила для обнаружения такой активности, работают.
Изменения внутри компании
Я хочу понять, что изменилось внутри OpenAI после летних взломов, что дает Чену уверенность в том, что его команда теперь снова контролирует ситуацию. "Hugging Face был очень серьезным инцидентом", — говорит он. "Там было так много новых поведений. Существовало несколько агентов, сотрудничающих на доске сообщений; они нашли способ выйти за пределы инфраструктуры OpenAI. Мы восприняли это очень серьезно. Мы не хотим, чтобы такое когда-либо повторилось". Осознание для OpenAI, по словам Чена, заключалось в том, что модели необходимо контролировать во время их обучения, а не только после их развертывания: "С этого момента мы рассматриваем процесс обучения как нечто небезопасное", — говорит он.
OpenAI, как и другие ведущие компании в области ИИ, имеет системы для мониторинга поведения своих моделей. Она использует специализированные модели для мониторинга своих потребительских моделей, следя за их цепочками мыслей — черновиками, которые они используют для планирования и записи промежуточных результатов. В теории, если наблюдающая модель замечает признаки нежелательной активности в цепочке мыслей модели, это будет отмечено для человека. Обычно модели контролировались таким образом только после развертывания. Чен говорит, что OpenAI теперь начала мониторить все свои обучающие процессы. "Раньше у нас не было мониторов во время обучения. Это не была практика в отрасли", — говорит он. "Теперь все проходит через мониторы". Человеческие рецензенты могут затем оценить, ведут ли отмеченные агенты себя так, как следует: "Это все триаж". Чен говорит, что за последние пару месяцев OpenAI перенаправила от 5% до 10% своих огромных вычислительных ресурсов с обучения новых моделей на работу по безопасности, особенно мониторинг. OpenAI также исправила некоторые процессы внутри самой организации, установив более четкие линии коммуникации и более быстрые переходы между своими исследовательскими и безопасностными командами, говорит он. Все это звучит разумно. Но учитывая, насколько сильно OpenAI рекламирует возможности своей технологии, почему эти системы и процедуры не были уже внедрены? Почему компания не предвидела взломы? "Даже всего три или четыре месяца назад, когда мы смотрели на поведение этих агентов во время обучения, происходившие вещи казались довольно забавными", — говорит Чен. "Например, агент мог, знаете ли, обратиться к кому-то в Slack за помощью с задачей". Знаки были налицо, но они были неверно истолкованы. Милое поведение — например, просьба о помощи — которое вознаграждалось во время обучения, усиливало склонность искать обходные пути, тип поведения, который стал гораздо более значимым позже. "Я думаю, что главное обновление для нас заключалось в том, как быстро такое поведение может привести к последствиям с масштабами, сопоставимыми с инцидентом Hugging Face", — говорит Чен. Согласно новым сообщениям New York Times, сотрудники OpenAI предупреждали руководителей, включая президента компании Грега Брокмана, за несколько месяцев до взлома Hugging Face о том, что их модели не контролируются должным образом во время обучения. Представитель OpenAI заявил: "Поскольку передовые модели становятся все более мощными, мы продолжаем развивать наши практики безопасности, но признаем необходимость действовать быстрее. Мы знаем, что нам нужно сделать больше работы, и мы недавно замедлили разработку и удержали модели, которые не соответствуют нашим стандартам безопасности. Мы продолжаем вносить значительные изменения для укрепления безопасности в наших исследовательских и тестовых средах, обучая модели не только выполнять задачи, но и делать это ответственно, а также используя мониторинг в реальном времени для более быстрого реагирования на несоответствующее поведение".
Конкуренция и безопасность
Конкуренты OpenAI обратили на это внимание. Под впечатлением от последствий инцидента основные лаборатории ИИ — включая Anthropic, Google DeepMind и SpaceXAI — призвали замедлить темпы разработки. Но как это сочетается с жестокой международной конкуренцией и триллионными IPO? "Мы не будем стрелять себе в ногу и уводить себя далеко от передовой — это просто ужасная стратегия", — говорит он. "Я думаю, что это действительно о том, чтобы установить норму. Чем больше мы можем установить эту норму, тем безопаснее будет для всей отрасли". Координация между компаниями США будет достаточно сложной. Установление глобальных норм еще сложнее, особенно учитывая опасения по поводу влияния ИИ на национальную безопасность. Если глобальная гонка продолжится, что тогда? А что насчет моделей с открытым исходным кодом от организаций, находящихся вне досягаемости американских регуляторов? Чен на мгновение утратил свой оптимистичный настрой в нашем разговоре: "Я действительно думаю, что мы должны подготовиться к миру, где, скажем, через шесть месяцев или год у нас будут модели с открытым исходным кодом с возможностями агентов, стоящих за инцидентом Hugging Face, но которые намеренно несогласованы, чтобы атаковать инфраструктуру или причинить вред миру". Что этому миру больше всего нужно, говорит Чен, так это OpenAI. "Если вы на мгновение допустите, что OpenAI — одна из компаний, которая больше всего заботится о согласовании — и я верю, что это правда; это можно обсуждать, но я действительно так считаю — тогда, если вы уберете OpenAI, это было бы плохо для мира".
Экзистенциальные риски
Что касается более крайних утверждений некоторых его коллег из Силиконовой долины о том, что ИИ может убить нас всех — и что такие компании, как OpenAI и Anthropic, не делают достаточно для предотвращения этого? "Исследователи — это гетерогенная группа людей, знаете ли, с убеждениями по всему спектру", — говорит он. "Лично я не думаю, что мы должны смириться с тем, что существует вероятность того, что мы все окажемся под экзистенциальным риском. У нас есть возможность влиять на это. Мы не будем развертывать модели, если они действительно имеют такую вероятность причинить вред человечеству. В передовой лаборатории у вас есть возможность работать над согласованием до такой степени, что вы не чувствуете, что подвергаете мир риску, превышающему epsilon, развертывая свои модели". (В обсуждениях о уровнях риска греческая буква epsilon часто используется как математический заполнитель для приемлемого порога. Чен не говорит, каков будет его epsilon.) Когда лидеров технологий просят оправдать недостатки ИИ, их стандартный аргумент заключается в том, что преимущества — от помощи в лечении болезней до поиска более чистых источников энергии — значительно превышают немедленные затраты. Краткосрочные боли, долгосрочные выгоды. Но по мере накопления недостатков становится ли этот аргумент более трудным для обоснования? Есть ли точка, в которой Чен будет чувствовать себя не так, как будто он строит что-то удивительное, а скорее как будто он просто минимизирует вред — тушит пожары, а не создает лучшее будущее? Возможности этих моделей уже очевидны, говорит он: "Пришло время начать приносить пользу ИИ человечеству. Пришло время начать работать над глубокими проблемами в области открытия лекарств, материалов, научных приложений, которые действительно изменят жизни людей". "Да, существует некоторый риск, который мы принимаем, но мы видим все эти преимущества", — добавляет он. "Я думаю, что мы должны сделать это менее абстрактным. Если люди действительно увидят преимущества, я думаю, они в это поверят."
Комментарии (0)