В последние годы специализированные языковые модели, такие как Qwen и Gemma, становятся все более популярными благодаря возможности дообучения на основе общих открытых моделей. Однако, несмотря на их универсальность, такие модели наследуют словарь, созданный для множества доменов и общих приложений. Это может привести к избыточным затратам, особенно в задачах, требующих высокой точности и эффективности, таких как автоматическая оценка эссе.
Проблема избыточности словаря
В одной из систем, которую мы используем в производственной среде — автоматическом оценщике эссе на португальском языке, построенном на базе Qwen3-4B, мы столкнулись с проблемой избыточного количества токенов. Модель, хотя и имеет всего 4 миллиарда параметров и уже была обучена для выполнения своей задачи, использовала оригинальный токенизатор Qwen3-4B, который был создан для работы с множеством языков и типов текстов. В результате, текст, который модель генерировала для каждой оценки, разбивался на множество токенов, что увеличивало затраты на вывод.
Влияние токенизации на производительность
Токенизаторы ведущих языковых моделей обучаются на больших коллекциях текстов из различных доменов и языков. Для универсальной модели это оправдано, но для специализированной модели это создает две основные проблемы: фрагментацию и избыточность. Фрагментация происходит, когда токенизатор разбивает повторяющиеся последовательности на множество токенов, например, JSON-обертку или стандартные фразы оценки. Избыточность же возникает из-за наличия в словаре множества токенов, которые не используются в данной задаче.
Как VocabX решает проблему
Мы разработали метод VocabX, который позволяет оптимизировать словарь, сосредоточив внимание не на частоте токенов, а на их стоимости. Это позволяет значительно сократить затраты на вывод, не меняя базовую модель. В процессе мы изменили подход к выбору токенов: вместо того, чтобы просто считать количество токенов, мы начали оценивать, сколько затрат и времени сэкономит каждый токен.
Два уровня оптимизации
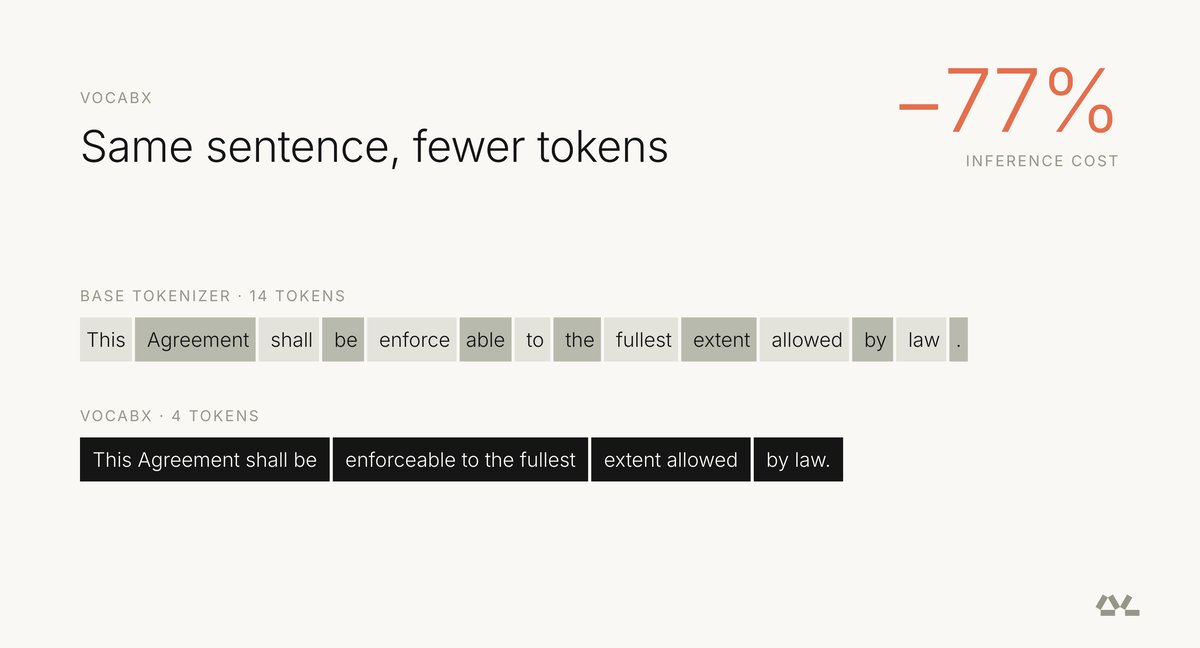
VocabX работает на двух уровнях: подуровне и многословном уровне. На подуровне мы изменяем, как слова разбиваются на токены, а на многословном уровне мы ищем повторяющиеся фрагменты текста, такие как короткие выражения или полные строки, и объединяем их в один токен, который мы называем макро-токеном. Это позволяет значительно сократить количество токенов, необходимых для выполнения задачи.
Результаты применения VocabX
Мы провели серию экспериментов, обучив семь версий оценщика с одинаковой базовой моделью и данными, но с различными токенизаторами. Все они обрабатывали одинаковое количество запросов на одной и той же тестовой машине. В результате мы наблюдали, что среднее количество токенов в ответе снизилось с 350 до 101, а затраты на вывод уменьшились на 77%. При этом качество оценивания, измеряемое по комбинированному баллу, возросло с 0.703 до 0.810.
Сравнение с другими методами
Для проверки эффективности VocabX мы сравнили его с тремя другими методами оптимизации словаря на пяти публичных доменах. В каждом случае VocabX показал лучшие результаты по сравнению с другими методами, обеспечивая более высокую степень сжатия и снижение затрат на вывод.
Заключение
Метод VocabX не делает модель умнее, но позволяет ей не платить за текст, который не нужно генерировать, и не оценивать токены, которые никогда не будут использованы. Это открывает новые возможности для оптимизации специализированных языковых моделей, начиная с уровня словаря. Полный метод и результаты экспериментов будут опубликованы в статье VocabX, которая выйдет в ближайшее время.
Комментарии (0)