В условиях растущего спроса на вычислительные ресурсы в области искусственного интеллекта, графические процессоры (GPU) становятся одними из самых дорогих и дефицитных ресурсов. Каждодневное управление общими кластерами требует от команд принятия решений о том, какие задачи запускать на каких GPU и в каком порядке. Эффективность этого процесса напрямую зависит от точности оценок времени выполнения каждой задачи. Если задача завершается на несколько часов раньше, GPU простаивают, ожидая следующей задачи. Если же она затягивается, это приводит к задержкам в очереди и сдвигу сроков выполнения экспериментов.
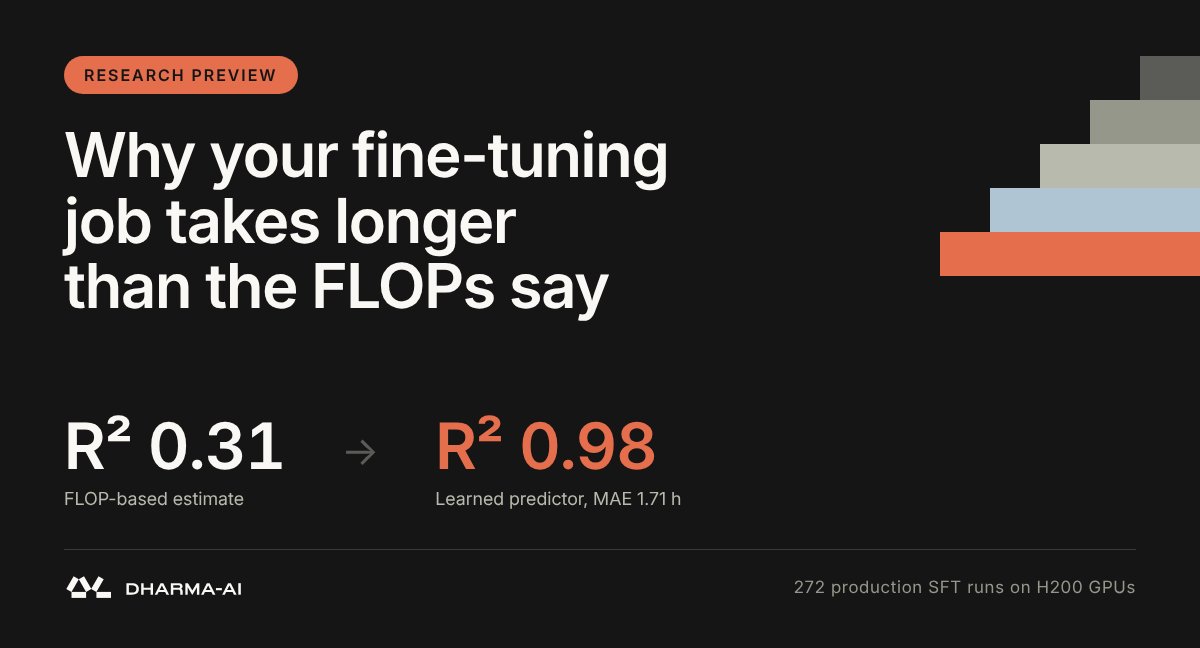
Для улучшения планирования и уменьшения времени простоя, необходимо более точное прогнозирование времени выполнения задач. В большинстве случаев команды используют простую оценку на основе количества операций с плавающей запятой (FLOP), которая часто оказывается далекой от реальности. Например, если расчет показывает, что задача займет девять часов, она может завершиться только на следующий день. Чтобы понять, насколько точны такие оценки, мы проанализировали 272 реальных задачи по супервайзинговому дообучению (SFT), выполненные на кластере NVIDIA H200, что составило около 7382 GPU-часов.
Проблемы традиционного подхода
Традиционная оценка времени выполнения задач основывается на расчетах FLOP, которые учитывают только вычислительные ресурсы. Формула для теоретического времени выполнения выглядит следующим образом:
T_theoretical = (6 · P · D) / (N_GPU · FLOPS_peak · MFU)
где P — количество параметров модели, D — количество обучающих токенов, N_GPU — количество используемых GPU, FLOPS_peak — пиковая производительность одного GPU, а MFU (Model FLOPs Utilization) — доля этой производительности, которую модель фактически достигает. Однако реальная производительность редко достигает пиковых значений из-за различных факторов, таких как трафик памяти и неэффективность коммуникаций. Обычно MFU колеблется между 30% и 60%, и заранее неизвестно, какое значение будет актуально для конкретной задачи.
Что мы сделали
Мы решили подойти к задаче прогнозирования времени выполнения как к задаче регрессии с учителем. Используя вектор признаков, составленный из конфигурации задачи и метаданных модели, мы предсказываем время выполнения с момента получения GPU до завершения задачи, исключая время ожидания в очереди. Важно, что все данные известны до начала выполнения задачи, что делает прогнозирование полезным для планирования.
Мы протестировали различные модели, включая линейную регрессию, Ridge, XGBoost и CatBoost. В результате CatBoost показал наилучшие результаты, достигнув R² = 0.98, со средней абсолютной ошибкой (MAE) 1.71 часа и медианной ошибкой 0.51 часа в кросс-валидации.
Результаты и выводы
Анализ показал, что традиционные оценки на основе FLOP не могут объяснить наблюдаемые результаты. Например, даже при использовании различных значений MFU, средняя ошибка оставалась высокой. Модель CatBoost, в отличие от традиционных методов, учитывает множество факторов, таких как частота оценок, политика сохранения контрольных точек и нагрузка на каждый GPU, что позволяет ей более точно предсказывать время выполнения.
Ключевые результаты:
Средняя продолжительность выполнения задач составила 23.43 часа, медиана — 15.29 часов.
80% прогнозов укладываются в 2.20 часа, 90% — в 4.31 часа.
Модель показывает низкую ошибку до 60 часов, но начинает испытывать трудности с задачами, превышающими этот порог.
Ограничения и дальнейшие шаги
Несмотря на высокую точность, модель имеет свои ограничения. Она была обучена только на задачах SFT с использованием GPU H200, и ее результаты не могут быть напрямую перенесены на другие типы GPU без дополнительного обучения. Также необходимо больше данных для задач с длительным временем выполнения. В будущем мы планируем расширить модель, добавив аппаратные дескрипторы и протестировав ее на других типах GPU.
Полная версия исследования будет опубликована на arXiv в ближайшее время. Мы приглашаем всех заинтересованных следить за обновлениями и делиться своим опытом в оценке времени выполнения задач на своих кластерах.
Комментарии (0)