Современные агенты на основе языковых моделей (LLM) больше не ограничиваются чтением единственного извлеченного фрагмента текста. С помощью Протокола Контекста Модели (MCP) агент может вызывать поисковый инструмент, просматривать структурированные записи пациентов или учетных записей, запрашивать базу данных и извлекать метаданные, а затем объединять всю эту информацию в один ответ. Это делает вопрос фактической достоверности более сложным, чем кажется на первый взгляд.
Системы, созданные для проверки ответов LLM, такие как RAGAS, MiniCheck, AlignScore и SummaC, обычно задают вопрос о том, поддерживается ли утверждение доступными доказательствами после их объединения. Однако в их обычной форме они не указывают, какой вывод инструмента MCP поддерживает каждое утверждение, или является ли это источником, на который ссылается ответ.
Наша последняя работа, ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents (читайте на Hugging Face или на arXiv), направлена на устранение этого пробела. Мы называем режим сбоя, который нас интересует, перекрестным смешиванием источников: утверждение, которое истинно где-то в доказательствах, но приписывается неправильному источнику. Проверка, не учитывающая источники, может пропустить это, поскольку факт существует в пуле. Проверка с учетом источников не должна этого делать.
Проблема атрибуции источников
Рассмотрим агента службы поддержки, который отвечает: "Согласно учетной записи, этот план включает 30-дневный период возврата". Период возврата может быть вполне реальным, но указан в документе политики, а не в учетной записи, на которую ссылается ответ. Объединив оба источника, мы видим, что утверждение выглядит поддержанным. Если же оставить их раздельными, атрибуция оказывается неверной, и в условиях, чувствительных к данным, неправильная атрибуция может быть столь же вредной, как и неправильный факт.
Аналогичный паттерн наблюдается в клиническом агенте, где специфическая информация о медикаментах пациента, полученная из инструмента истории болезни, становится вводящей в заблуждение, как только ответ представляет ее как вывод из медицинской литературы. Утверждение может поддерживаться одним источником MCP, в то время как ответ приписывает его другому. Проверка, не учитывающая источники, видит поддержку в объединенных доказательствах и пропускает это; ProvenanceGuard отдельно проверяет, соответствует ли поддерживающий источник тому, который упоминается или подразумевается в ответе.
Как работает ProvenanceGuard
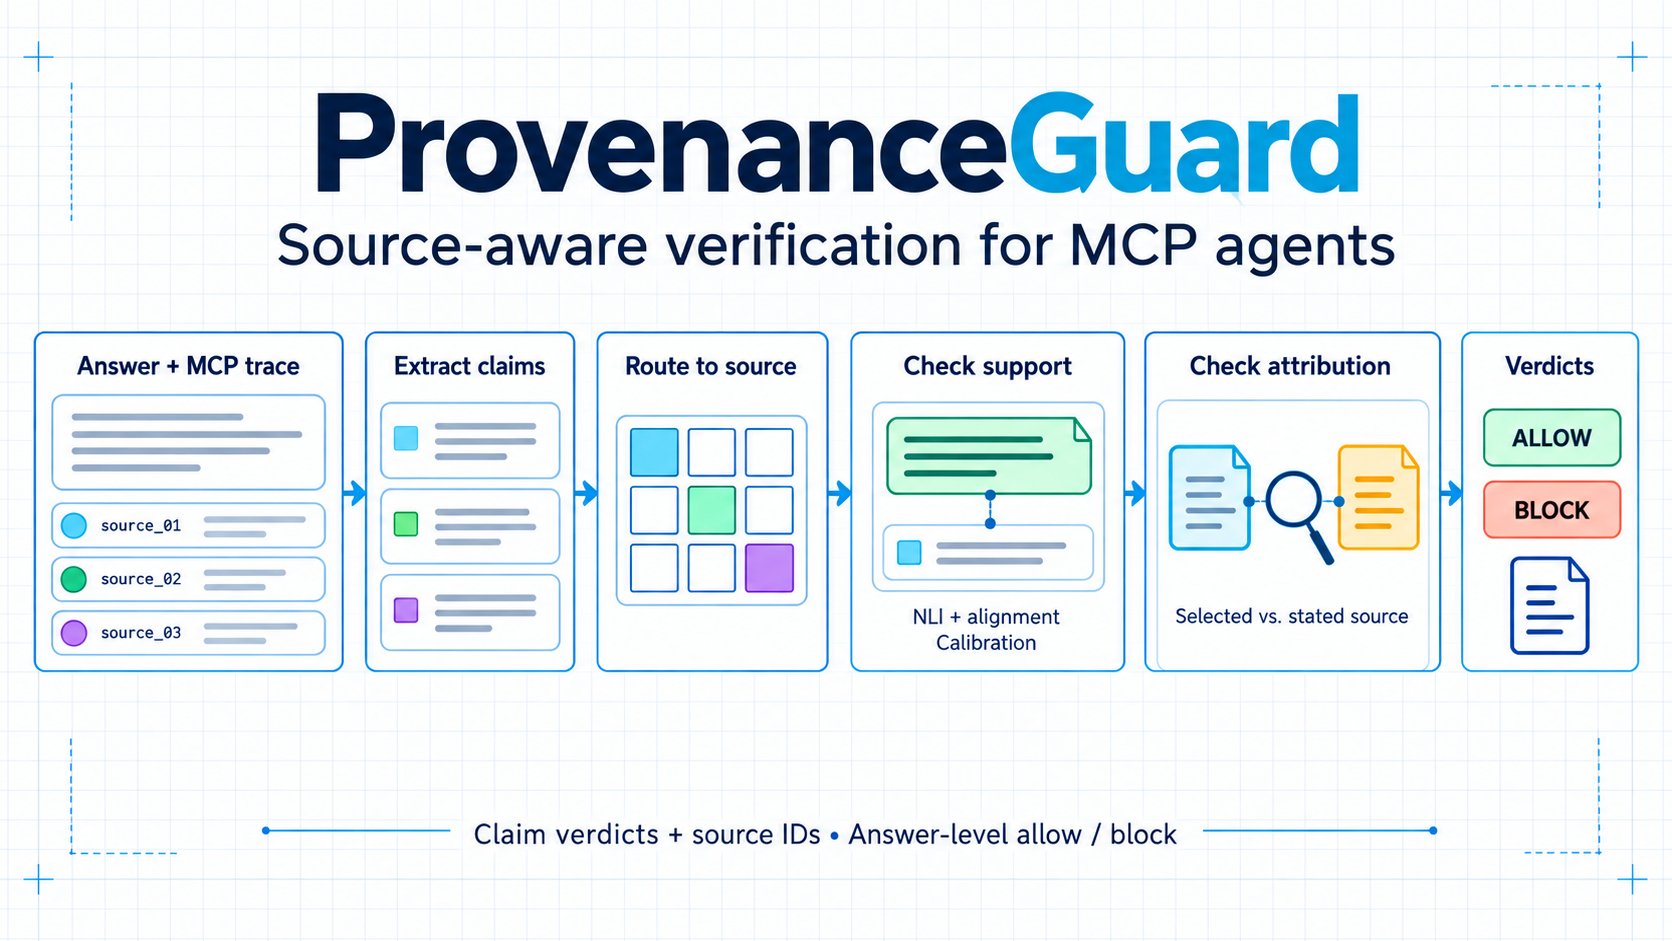
ProvenanceGuard — это слой проверки после генерации, который работает поверх черного ящика агента MCP. Он запускается после того, как агент выдает ответ, и никогда не объединяет доказательства в один анонимный контекст. Вместо этого он сохраняет идентичность источника на протяжении всего процесса. Он читает захваченную трассу MCP, включая выводы инструментов и их идентификаторы источников, без переобучения агента. Затем он выполняет пять последовательных действий:
1. Разбивает ответ на конкретные утверждения.
2. Находит наиболее релевантный источник для каждого утверждения.
3. Проверяет, поддерживает ли этот источник утверждение.
4. Сравнивает источник с тем, который упоминается или подразумевается в ответе.
5. В конечном итоге выдает как вердикт по каждому утверждению, так и глобальное решение о разрешении или блокировке ответа.
Идентичность источника сохраняется через декомпозицию, маршрутизацию, оценку поддержки, проверку атрибуции и исправление, а не объединяется в один пул. Заблокированные ответы могут пройти через цикл исправления в стиле RARR и быть повторно проверены.
Дизайнерские решения и результаты
Для экспериментов в нашей работе мы использовали локальные модели, чтобы захваченные трассы могли обрабатываться в контролируемой оффлайн-обстановке. MiniLM помогает находить релевантные источники, модель DeBERTa NLI проверяет, поддерживает ли этот источник утверждение, а локальная языковая модель помогает разбивать ответы на утверждения. Проверяющий также внимательно проверяет буквальные значения: число, дата или идентификатор, отсутствующий в источнике, не может пройти проверку только потому, что предложение звучит правдоподобно.
Калиброванный шаг принятия решения объединяет эти сигналы. Если ответ заблокирован, шаг исправления в стиле RARR может попытаться выполнить исправление, основанное на источнике, или безопасный запас, который затем проверяется снова.
Мы протестировали ProvenanceGuard на ответах от медицинского агента, который использовал записи пациентов, исследовательские статьи и другие инструменты. Это дало нам 281 реальную трассу для изучения. Медицина является полезным тестом, поскольку факт из записи пациента и факт из общей научной литературы не могут рассматриваться как один и тот же источник. Для основного теста эксперты проверили 361 утверждение из 40 ответов, отложенных от данных, использованных для разработки системы.
Наиболее прямой результат: эксперты сказали, что 139 утверждений не должны проходить, и ProvenanceGuard поймал 138 из них. Он пропустил одно. Он также удержал 67 утверждений, которые эксперты считали поддержанными, отправив их на повторную проверку или исправление. Это отражает осторожную настройку, которую мы тестировали: она предпочитает вторую проверку некоторых поддержанных утверждений, чем пропуск неподдержанных.
Для утверждений с идентифицируемым источником ProvenanceGuard также правильно выбрал источник примерно в 86% случаев в этом тесте. Мы провели четыре других проверщика поддержки на тех же утверждениях. ProvenanceGuard показал наивысший результат по критерию, как хорошо система блокирует утверждения, которые должны быть заблокированы, избегая ненужных блокировок. Другие проверщики в этом сравнении не указывали, какой вывод инструмента поддерживает каждое утверждение. ProvenanceGuard фиксирует эту связь, чтобы рецензент мог видеть проверенный источник для каждого утверждения и принятое решение.
Заключение
ProvenanceGuard представляет собой важный шаг в развитии систем проверки фактической достоверности для агентов LLM, обеспечивая более точную атрибуцию источников и улучшая качество ответов. Это особенно актуально в таких областях, как медицина, где точность информации имеет критическое значение. С помощью ProvenanceGuard мы можем не только улучшить качество ответов, но и обеспечить безопасность данных, сохраняя контроль над источниками и их атрибуцией.
Комментарии (0)