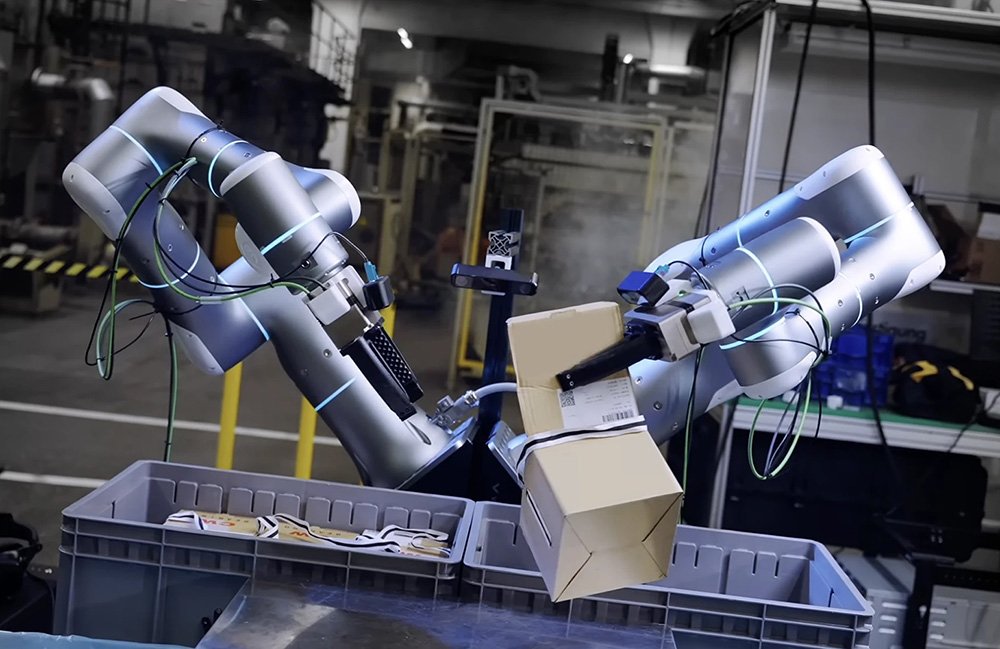
Компания Rhoda AI, вышедшая из режима скрытого существования в начале 2023 года, привлекла $450 миллионов в рамках раунда финансирования Series A. Основная цель компании — разработка и внедрение модели прямого видео-действия (DVA) для робототехники в таких отраслях, как автомобилестроение, производство, логистика и электронная коммерция. Как отметил соучредитель и CEO Rhoda AI Джагдип Сингх, "Мы сосредоточены на внедрении в реальный мир, а это значит, что необходимо учитывать всю его сложность. Каждое выполнение может быть разным, и для этого нужна действительно надежная модель".
Проблема недостатка данных
Сингх подчеркивает, что для создания надежной модели требуется обширный набор данных для обучения. В отличие от языковых моделей, таких как ChatGPT, которые были обучены на огромных объемах текстовой информации, физическая искусственная интеллектуальная система сталкивается с проблемой отсутствия аналогичного объема данных о физическом мире. "Каждое слово, когда-либо опубликованное в интернете, от Шекспира до Reddit, использовалось для обучения этих AI моделей. В мире физического AI такого интернет-объема данных не было", — говорит он.
Модель DVA и ее особенности
Rhoda AI разрабатывает модель DVA, которая отличается от других подходов, таких как модели визуально-языкового действия (VLA). Эти последние позволяют роботам учиться на данных из изображений или видео, но все еще испытывают трудности с учетом изменчивости реального мира. Модель DVA, в свою очередь, сочетает манипуляцию и мобильность в одной политике. Сингх объясняет: "Модель анализирует историю видеокадров и токенов действий и языка. На основе этого контекста она делает предсказание о следующем событии в видео на несколько сотен миллисекунд вперед".
Процесс работы модели
Работа модели включает несколько этапов:
Наблюдение: Модель делает наблюдение за текущей ситуацией.
Предсказание: На основе наблюдения она предсказывает, что произойдет дальше.
Конвертация действия: Предсказанная сцена передается второму компоненту модели, который преобразует ее в действия робота.
Исполнение: Робот выполняет предсказанные действия, после чего цикл повторяется с новым наблюдением.
Значение объема данных
Сингх утверждает, что любой AI, обученный на небольшом наборе данных, будет хрупким. "Сотни лет видео были использованы для обучения модели, поэтому она видела невероятное разнообразие всего: от бейсбольных матчей до волн, разбивающихся о берег", — добавляет он. Это разнообразие позволяет модели учиться не только на человеческих действиях, но и на других аспектах физического мира.
Подход к обучению
Rhoda AI использует видео данные для предварительного обучения, а затем применяет небольшое количество специфического обучения для конкретных задач, что позволяет модели адаптироваться к требованиям конкретного производства. "Мы обнаружили, что модели, которые показывают наилучшие результаты, обучены на самых широких наборах данных, включая те, которые не очевидно связаны с манипуляцией", — говорит Сингх.
Предложение Rhoda AI
Компания предлагает свои технологии в различных форматах, сохраняя за собой контроль над AI-слоем. "Мы можем работать как с нашим оборудованием, так и с оборудованием третьих сторон", — поясняет Сингх. Внутренне Rhoda AI сосредоточена на разработке навыков в производстве и логистике, где наблюдается нехватка рабочей силы.
Будущее робототехники
Сингх уверен, что "момент ChatGPT для робототехники" наступит быстрее, чем ожидается. Он считает, что подход Rhoda AI имеет потенциал для достижения этого уровня универсальности благодаря масштабному и разнообразному набору данных. "Если у вас нет обоих этих компонентов, ваши модели не смогут обобщать достаточно хорошо", — подводит итог Сингх.
Комментарии (0)