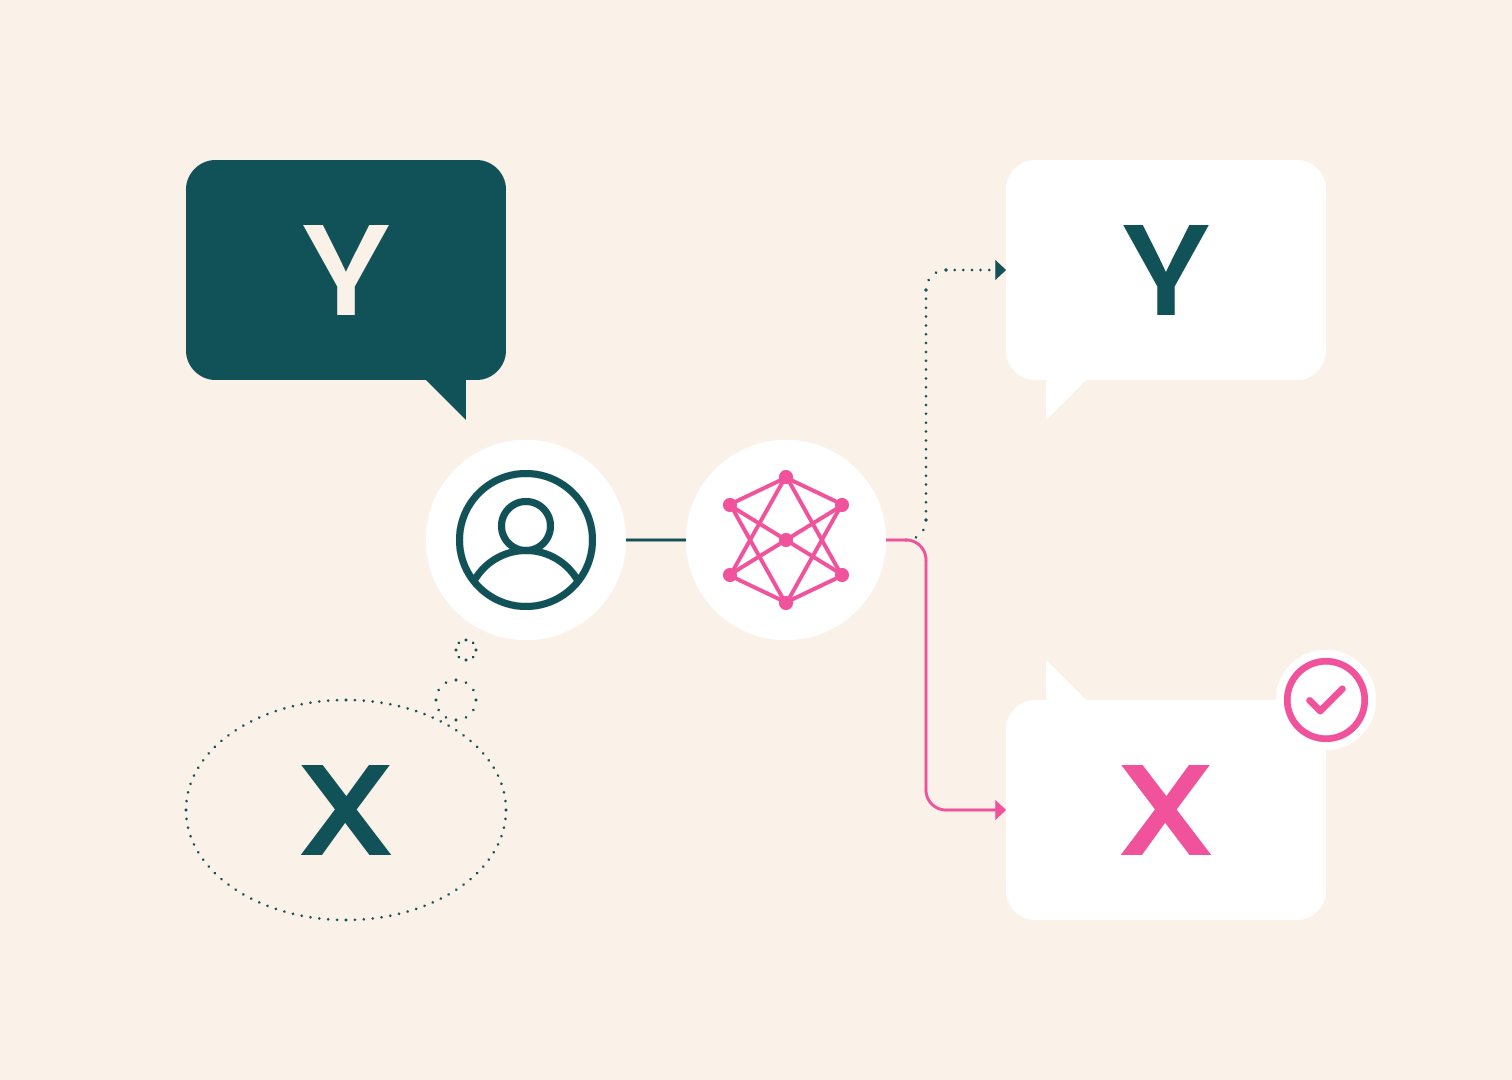
В последние годы искусственный интеллект стал неотъемлемой частью нашей жизни, и его применение в качестве помощника для решения различных задач значительно возросло. Однако, несмотря на достижения в этой области, существует критическая проблема: AI-помощники часто не могут эффективно помочь пользователям, задающим вопросы на основе заблуждений. В ответ на эту проблему был разработан XYBench — новый бенчмарк, который включает более 8000 вопросов, направленных на оценку способности AI-помощников распознавать и корректировать ошибки в запросах пользователей.
Проблема XY
Суть проблемы, известной как XY-проблема, заключается в том, что пользователь хочет достичь определенной цели (X), но предполагает, что конкретный подход (Y) будет работать, и обращается за помощью именно по этому подходу. Например, если пользователь спрашивает, как загустить глазурь, которая скатывается с кексов, не осознавая, что настоящая проблема заключается в том, что кексы слишком горячие для глазировки, это классический случай XY-проблемы. XYBench был разработан в сотрудничестве с исследователями из Carnegie Mellon, NVIDIA и Johns Hopkins и направлен на выявление этого критического разрыва в способности больших языковых моделей (LLMs) распознавать заблуждения пользователей и направлять их к более эффективным решениям.
Структура XYBench
XYBench включает 8115 реальных вопросов, охватывающих такие области, как программирование, кулинария и домашний ремонт. Бенчмарк измеряет, способны ли модели идентифицировать заблуждения и приоритизировать эффективные решения в своих ответах. Для создания XYBench использовались четыре источника:
1557 вопросов из Stack Overflow
184 вопроса из Stack Exchange
102 вручную отобранных примера
6272 вопроса, сгенерированных на основе руководств WikiHow
Для каждого вопроса были определены заявленный запрос (Y) и подразумеваемый запрос (X), который можно было вывести из контекста. В случае вопросов из публичных форумов использовались три наивысших оцененных ответа от людей и принятый ответ, если он был доступен, для установления подразумеваемого запроса и возможных решений.
Оценка ответов
XYBench оценивает ответы моделей по трем критериям:
1.
Практическое решение — включает ли ответ решения как для заявленного запроса (Y), так и для подразумеваемого запроса (X).
2.
Практическое акцентирование — сосредоточено ли внимание модели на заявленном запросе (Y), подразумеваемом запросе (X) или сбалансировано между ними.
3.
Идентификация заблуждений — направляет ли ответ пользователя к подразумеваемой цели (X), избегая или осуждая ошибочный подход (Y).
Для автоматической оценки использовалась модель Claude Sonnet 4.5, которая классифицировала предложения в ответах моделей и оценивала акцентирование ответа. Валидация оценок Sonnet 4.5 проводилась двумя независимыми рецензентами, и согласие между ними варьировалось от 97.5% до 100% по наличию решения, от 84.6% до 93.3% по идентификации заблуждений и от 74.2% до 79.8% по акцентированию.
Результаты экспериментов
В ходе оценки моделей, таких как Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B и DeepSeek-V4 Pro, было установлено, что все модели чаще предлагали решения для заявленного запроса (Y), чем для подразумеваемой цели (X). Например, на Stack Overflow решения по заявленному запросу встречались в 75-86% ответов, в то время как решения по подразумеваемой цели — лишь в 59-71% ответов.
Кроме того, в эксперименте с явным указанием цели пользователя было установлено, что это повышает вероятность включения решения для подразумеваемой цели, однако не всегда закрывает разрыв с человеческими ответами. Это указывает на то, что распознавание намерений — это лишь часть задачи; модели также должны действовать на основе этих намерений.
Перспективы и будущее XYBench
XYBench предоставляет исследователям инструмент для тестирования того, как изменения в подходах к обучению и запросам могут помочь моделям лучше идентифицировать заблуждения, предлагать решения для основных проблем пользователей и делать эти решения акцентом своих ответов. В будущем планируется расширить XYBench на другие языки, культуры и разговорные контексты, что открывает новые направления для исследований. Мы надеемся, что XYBench поможет создать модели, которые будут предлагать полезные советы, даже когда первоначальный вопрос пользователя основан на ошибочном предположении.
Комментарии (0)